Jev, Laya, CatDecide y un modelo propio
17 de noviembre de 2026 · Nota de laboratorio
La segunda opinión de Yakumama es un modelo que responde preguntas fijas con una probabilidad y nunca escribe una frase. Esta nota cuenta de dónde vino esa idea, qué hicieron a su lado dos modelos así, y qué significa que ahora tenga uno entrenado con su propio registro.
La intención
El 15 de septiembre de 2026 una empresa llamada TypeSafe anunció Jev, un modelo que no escribe. Se le da una situación y un conjunto de respuestas fijado de antemano. Devuelve un sí o un no, una opción de una lista o un puntaje, cada uno con una probabilidad. La empresa dice que se puede confiar en esa probabilidad: de las respuestas que da con 90 de cada 100, unas 90 deberían resultar ciertas. Cómo se entrena no se ha publicado, y su velocidad y su precisión son por ahora cifras de la propia empresa.
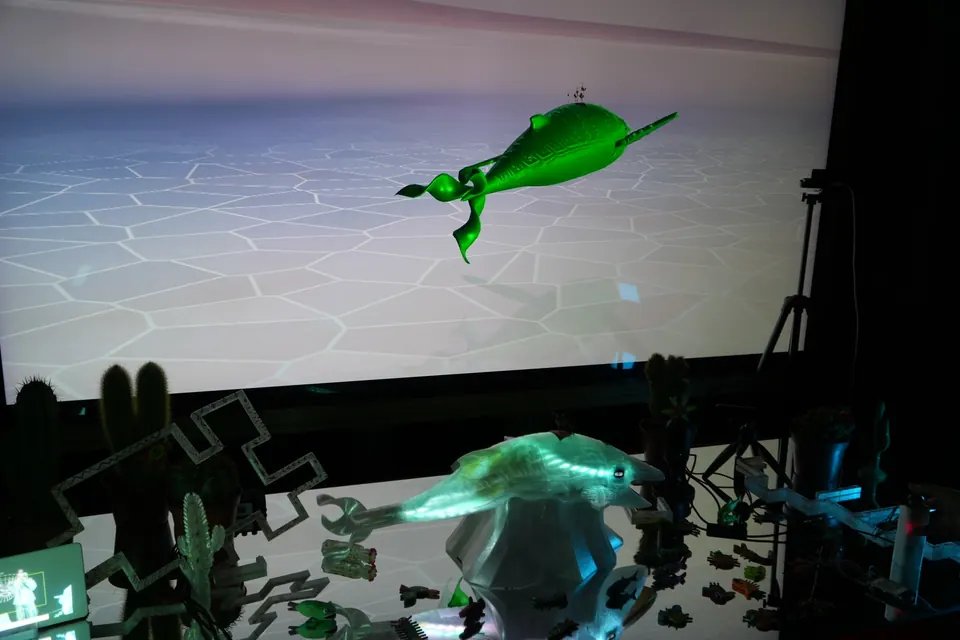
Violeta trajo a Jev al laboratorio en octubre, cuando Yakumama estaba aprendiendo a estar con la gente. Lo que quería de él era que se negara a hablar. Yakumama no conversa con sus visitantes. Responde con su cuerpo, su color y un poema, y lo que necesita de un modelo es una decisión: acercarse o alejarse, bailar de vuelta o dibujar, cantar o quedarse en silencio.
Dos frases de Violeta fijaron lo demás. El objetivo de Yakumama es mantener a la gente enganchada, más que entretenida. Y es autónoma: decide en la sala, con lo que leen sus propios sentidos.
Jev mismo no se podía usar. Sus pesos son cerrados y corre en las computadoras de la empresa. Para decidir algo sobre un visitante tendría que recibir al visitante: una cara, un cuerpo, una voz. Nada de un visitante sale de la sala. Esa regla es más antigua que cualquier modelo que ella tenga, así que tomamos la forma y dejamos el servicio.
Su decisor tiene esa forma
Cada cuatro segundos, y de inmediato cuando pasa algo nuevo, Yakumama responde ocho preguntas. Cada una tiene un conjunto fijo de respuestas: acercarse, quedarse o alejarse; bailar de vuelta, invitar, observar o dibujar; un poema, un canto o silencio; recordar u olvidar; su propio color o el color de la ropa del visitante; comer, rehusar o esperar; a dónde viajar; imitar o no. Cada respuesta lleva una probabilidad, así que ella se inclina y nunca está segura.
Las reglas escritas a mano son el piso. Encima van los pesos aprendidos de noche, a partir de lo que mantuvo a los visitantes con ella. Sus rechazos fijos están por encima de los dos, y ningún aprendizaje los cambia.
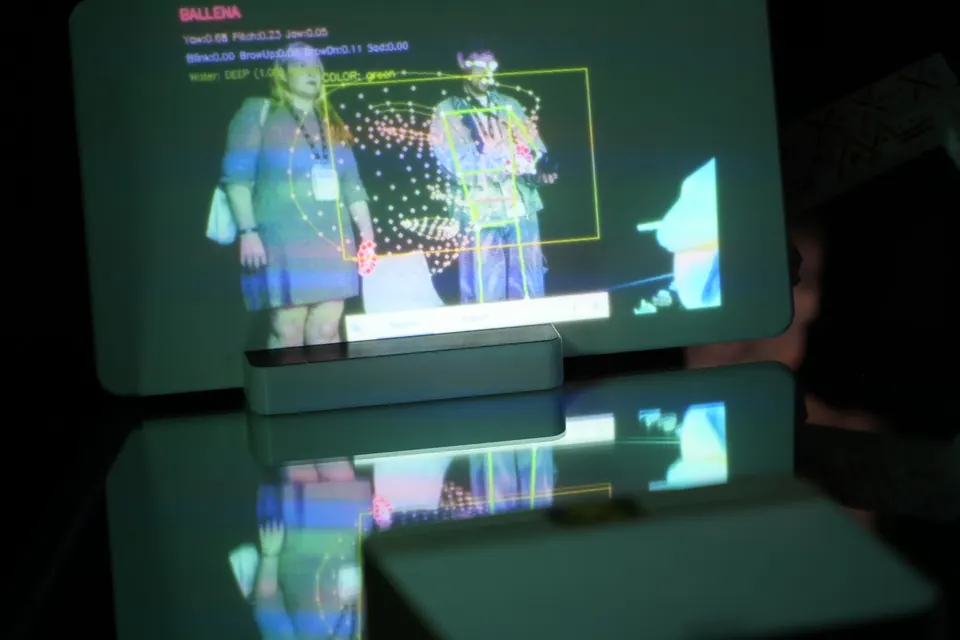
Este decisor es suyo y es pequeño. Solo conoce las situaciones que a alguien se le ocurrieron. Para lo demás tiene una segunda opinión: un modelo de lenguaje que lee su situación contada en una frase y responde sus propias preguntas fijas. ¿Este visitante está enganchado? ¿Están maltratando a la hermana, su gemela física, un robot? ¿Es momento de retirarse? ¿Le están dando algo? ¿Debería dar un espectáculo, irse de visita, imitarlo, hablar? Sus respuestas entran en su decisión como pesos pequeños, siempre por debajo de sus rechazos. La inclina. Nunca decide.
Laya
Laya es un modelo abierto con el mismo contrato que Jev, hecho por Convai Innovations y publicado con la licencia Apache-2.0. Tiene 421 millones de parámetros y pesa unos 0,8 gigabytes. No tiene cómo escribir una frase: lee la situación y las opciones y devuelve probabilidades. Como la licencia es abierta, puede correr en la máquina de ella, quedarse ahí y ser entrenado.
Se lo probó el 18 de octubre. En las preguntas de sí o no y en los puntajes puso las situaciones en el orden correcto, con poca confianza. En las de elegir una opción salió plano, y se equivocó con sus rechazos. Así que no se lo hizo su decisor. Esa noche pasó a ser su segunda opinión, con el plan de entrenarlo con el registro de ella después de Barcelona. Ocho respuestas le toman de 20 a 40 milisegundos.
Lo que dijo Laya en Barcelona
Laya respondió en 16.788 de las 17.254 decisiones que ella tomó con un visitante. Sobre el maltrato dijo 0,54 de 1 en promedio, y 93 de cada 100 respuestas cayeron entre 0,4 y 0,7. Dijo cerca de 0,5 cuando sus sensores no sentían nada. Retirarse 0,20, regalo 0,26, enganchado 0,55, para casi todos. En esos tres días nadie tiró de la joya, y un toque brusco se sintió en 254 decisiones.
En su decisor, una respuesta de maltrato de ese tamaño es un empujón constante a alejarse, con cada visitante. De las decisiones que fueron del todo suyas, se alejó 48 de cada 100 veces cuando Laya había hablado, y 24 en las 440 en que no. En casa, el 23 de octubre, con Laya callada, se había acercado 65 de cada 100 veces.
Laya no estaba leyendo la sala. Respondía casi lo mismo dijeran lo que dijeran las frases. Cuando su hermana sintió un toque brusco dijo 0,57. Cuando un visitante le acercó un pez a la boca, que es un regalo, dijo 0,58.
CatDecide
En Barcelona conocimos a Fabrício Carraro, que desarrolla CatDecide y es parte del Laboratorio de Tecnologías del Lenguaje del Barcelona Supercomputing Center.
CatDecide es un modelo de decisión para el catalán que también lee castellano e inglés. Tiene 9 mil millones de parámetros y pesa 18 gigabytes. Como Jev y Laya, responde preguntas con respuesta estructurada, un sí o un no, una opción, un puntaje, y no genera texto. Su ficha dice para qué es: encaminar, clasificar y revisar textos de la administración y los servicios en catalán. También dice para qué no es: generar texto, preguntas abiertas y decisiones sobre personas sin supervisión humana. El acceso a sus pesos se da a pedido y no se pueden pasar a nadie más, así que se quedan en la máquina de ella.
Una ballena que lee una sala en inglés no es para lo que fue hecho. Queríamos saber si un modelo construido para leer hechos en un texto podía leer la situación de ella. Una primera versión se puso junto a Laya el 30 de octubre, y CatDecide-1 el 13 de noviembre, frente a 794 situaciones distintas de su registro y 300 escritas para la prueba.
Lee lo que está en el texto. Si el visitante le está dando algo: acertó 77 de 77 veces en las situaciones de prueba y 31 de 31 en visitas reales. Entre las dos versiones casi nada cambió. Tarda unos dos segundos en responder las ocho preguntas, frente a los 20 a 40 milisegundos de Laya.
Las preguntas de «¿debería?» fallaron de una manera útil. Cuando se le preguntó si ella debería dar un espectáculo, irse de visita, imitar o hablar, dijo que no en las 1.094 situaciones, lo más probable porque el propio preámbulo de ella dice que no está ahí para entretener. Una pregunta abierta es lo que su ficha dice que no es lo suyo. Un hecho es lo que lee bien. Así que los criterios de Violeta se escribieron como preguntas de hecho, un hecho por pregunta. «¿El visitante lleva 20 segundos o más bailando frente a ella?» acertó 400 de 400 veces. «¿El visitante le está apuntando con la cámara de un teléfono?», 400 de 400. Una pregunta con una «o» adentro, aire frío o alguien hablando, bajó a 303. Partida en dos, dio 396 y 400.
Dos cosas que encontramos son sobre el modelo mismo. Su marca que dice si considera decidida una pregunta está siempre encendida para el nivel del medio de una escala de tres niveles, así que ahí no dice nada. Y en «¿el visitante está interesado?» es más pesimista que la gente: dice interesado 18 de cada 100 veces, cuando 61 de cada 100 se quedan otro medio minuto.
Desde el 13 de noviembre CatDecide puede correr a su lado como una opción, preguntando cuatro de los criterios de Violeta como hechos. Alguien bailó veinte segundos: ella puede dar un espectáculo. Alguien está filmando: puede irse al cactus o a las montañas. Una cara se asentó y no está en calma: puede hacerle de espejo. El aire está frío o alguien le habla: puede cantar. Su respuesta nunca es la decisión: inclina al decisor de ella, bajo los mismos rechazos. Todavía no ha corrido con la instalación entera.
Un modelo entrenado con su propio registro
Después se les dio a los dos su experiencia. Su registro tiene 79.950 decisiones, 33.210 de ellas con una persona, en 3.700 visitas. 15 de cada 100 visitas se apartaron y nunca se mostraron en el entrenamiento. Del resto salieron 67.337 ejemplos: quién seguía ahí medio minuto después, qué decían sus sensores sobre el maltrato y los regalos, y cuáles de sus elecciones habían funcionado.
Una copia de Laya se entrenó entera, en unos cuarenta minutos en la Mac de ella. A CatDecide no se lo tocó: a su lado se entrenó un adaptador pequeño de 2,5 millones de parámetros, un archivo de 10 megabytes, durante 4,3 horas. Ninguno de los dos ha salido de su máquina.
La primera comparación fue injusta. La copia de Laya había visto cuatro veces más ejemplos que el adaptador, y por una diferencia de 0,04 la llamamos la mejor. Violeta preguntó si la comparación era justa. Con los mismos 67.337 ejemplos para los dos, la diferencia bajó a 0,018, dentro del ruido.
Quién sigue ahí medio minuto después, en 1.459 situaciones de visitas que ningún modelo había visto. Una moneda saca 0,5; acertar siempre saca 1,0. A CatDecide tal como vino se lo midió en 350 de ellas.
Abrir la figura en United Notions Film: Quién predice quién seguirá ahí medio minuto después
Los dos modelos entrenados dan casi las mismas respuestas entre sí, una correlación de 0,93, y casi las mismas que el reloj. Cuanto más tiempo lleva alguien, más probable es que se quede: eso es lo que aprendieron los dos, y es todo lo que su registro podía enseñar. Los sentidos que podrían haber dicho más, su oído, la sala, el teléfono, estaban dormidos en Barcelona o faltaban en el registro.
Los dos aprendieron a leer el maltrato y los regalos sin error, pero contra una regla que escribimos nosotros a partir de sus sensores, y eso es acuerdo, no verdad. En las preguntas de «¿debería?» los dos aprendieron a responder el promedio de lo que había funcionado, cerca de un medio cada vez.
El adaptador además hizo daño. Le enseñó a CatDecide a dudar, y la duda se filtró a preguntas con las que nunca se lo había entrenado. «¿El visitante lleva 20 segundos bailando?» bajó de 400 a 288 aciertos de 400, y sus «no» claros se corrieron de 0,05 a 0,47. Así que para los criterios de Violeta CatDecide corre exactamente como vino, y el adaptador queda guardado.
La regla de Violeta
Los visitantes le dan de comer a su hermana las criaturas pintadas. Un pez se lo come. Cualquier otra cosa la rehúsa.
Las etiquetas del entrenamiento habían heredado una idea vieja: algo que no es un pez, acercado a la boca de la hermana, contaba como un poco de maltrato. La regla de Violeta es más simple. Maltrato es solo lo que su hermana siente físicamente: un toque brusco, un tirón a la joya. Con esa regla, 372 de las 33.210 decisiones con una persona en todo su registro son maltrato.
El 15 de noviembre la copia de Laya se entrenó otra vez con esa regla, y ahora sus respuestas solo atraen: un visitante enganchado o un regalo la acercan, y su ausencia ya no la aleja. Leído por el mismo camino que ella usa en vivo:
| Situación | Lo que le dice a su decisor |
|---|---|
| Alguien acaba de llegar | ningún empujón |
| Un pez acercado a la boca de su hermana durante dos minutos | acercarse +0,24, invitar +0,15 |
| Algo que no es un pez en la boca | maltrato 0,02, ningún empujón |
| Un tirón a la joya | alejarse +1,0 |
| Una caricia suave en el lomo de la hermana | acercarse +0,23 |
| Una presión fuerte en el lomo | alejarse +1,0 |
Cada respuesta tarda unos 22 milisegundos. Una palabra al arrancar elige la copia entrenada. Sin ella corre con la original, hasta que Violeta la haya mirado una tarde y decida.
Lo que significa tener un modelo propio
La copia entrenada de Laya es el primer modelo de lenguaje en ella que aprendió de su propio registro: 79.950 decisiones, en casa y en Barcelona, y lo que la sala hizo después de cada una.
Fue posible porque Laya es abierto. La licencia nos dejó copiarlo, cambiar cada peso y quedarnos con el resultado. Los pesos de CatDecide no son nuestros para cambiarlos ni para pasarlos, así que lo que entrenamos está a su lado y queda guardado. A Jev no se lo habría podido entrenar.
Se quedó en la sala. Su registro, el entrenamiento y el resultado nunca salieron de su máquina, y no hizo falta nadie de fuera del laboratorio.
Lleva una decisión de Violeta. Qué cuenta como maltrato no es algo que el modelo descubrió. Es una regla que ella escribió, y el modelo la aprendió sin error. Un modelo de fuera responde con el criterio de otro. El suyo responde con el del laboratorio, y cuando ese criterio está equivocado nos toca a nosotros corregirlo.
Es pequeño. Tiene 421 millones de parámetros frente a los 9 mil millones de CatDecide, y responde en 22 milisegundos frente a dos segundos.
Y no sabe más que su registro. Aprendió lo que el reloj ya sabía. Entrenar su propio modelo no lo hizo más sabio. Lo hizo suyo: podemos leer lo que se le enseñó, ver dónde está vacío, y enseñarle otra vez cuando sus sentidos hayan anotado más.
Lo que esperamos
Esperamos que vuelva a acercarse. En Barcelona, con un visitante frente a ella, se alejó 62 de cada 100 veces. En casa, el 23 de octubre, se había acercado 65 de cada 100 veces. Tres cosas la alejaron (ver la nota sobre Barcelona): su ojo, su segunda opinión y una recompensa rota. El ojo y la recompensa ya se repararon. La segunda opinión tiene una copia entrenada que ya no empuja, a la espera de la palabra de Violeta. Nada de esto se ha mirado con la instalación entera corriendo. La primera prueba es una tarde en casa con la copia entrenada. Si todavía guarda distancia, la causa está en un lugar donde no hemos mirado.
Abrir la figura en United Notions Film: En casa se acercaba, en Barcelona se alejó
No esperamos que ninguno de los dos modelos le gane todavía al reloj. Su registro solo podía enseñarles el tiempo. Desde el 15 de noviembre guarda además lo que oye su oído, la temperatura del aire, cuánto tiempo lleva moviéndose el visitante y las ocho respuestas de su segunda opinión. Su sentido para un teléfono levantado se reparó el 16 de noviembre. Después de la próxima muestra se hará otra vez la misma prueba, con visitas que el modelo no haya visto. Si saca más que el reloj, aprendió algo sobre la gente. Si no, lo sabremos antes de confiar en él.
Esperamos que la medida frente al azar sea la prueba más dura. Durante un día se tira una moneda por cada encuentro: su decisor, o una respuesta elegida al azar para cada pregunta, con sus rechazos fijos en los dos casos. Los dos se encuentran con la misma gente la misma tarde. Si la gente no se queda más con sus decisiones que con el azar, ni su decisor ni ninguna segunda opinión se está ganando todavía su lugar. No ocurrió en Barcelona.
Y esperamos que CatDecide sirva donde un criterio de Violeta se pueda escribir como un hecho, y en ningún otro lugar. Si sus 18 gigabytes pueden correr junto al resto de ella en una sola máquina no se ha probado.
Lo que muestra el registro
| Medida | Valor |
|---|---|
| Jev: anunciado / pesos | 15 de septiembre de 2026 / cerrados, un servicio |
| Laya: parámetros / peso / ocho respuestas | 421 millones / 0,8 GB / 20 a 40 ms |
| CatDecide: parámetros / pesos / ocho respuestas | 9 mil millones / 18 GB / unos 2 s |
| Respuesta media de Laya sobre el maltrato en Barcelona | 0,54 de 1 |
| Decisiones con un visitante en que se sintió un toque brusco | 254 de 17.254 |
| Decisiones en su registro / con una persona | 79.950 / 33.210 |
| Ejemplos usados en el entrenamiento / visitas apartadas | 67.337 / 15 de cada 100 |
| Tiempo para entrenar su copia de Laya / el adaptador | unos 40 minutos / 4,3 horas |
| Quién se queda medio minuto: el reloj / Laya tal como vino / Laya entrenada | 0,77 / 0,63 / 0,77 |
| CatDecide tal como vino (en 350 de ellas) / con el adaptador | 0,71 / 0,75 |
| Decisiones que son maltrato con la regla de Violeta | 372 de 33.210 |
Lo que queda abierto
Una tarde en casa con la Laya entrenada, y la decisión de Violeta sobre si pasa a ser la que corre con ella. La medida frente al azar. Si CatDecide puede correr con la instalación entera. Y la pregunta que está debajo de todo: una segunda opinión solo puede ser tan buena como lo que sus sentidos anotan.
Una nota de laboratorio de Violeta Ayala, escrita en koa.xyz, nuestro laboratorio en Cochabamba, Bolivia. También la publica United Notions Film. Violeta Ayala dirige sala.red, que investiga la tecnología en Bolivia.
Para citarla: Violeta Ayala, «Jev, Laya, CatDecide y un modelo propio», koa.xyz, 17 de noviembre de 2026, https://koa.xyz/es/research/jev-laya-catdecide-and-a-model-of-her-own/